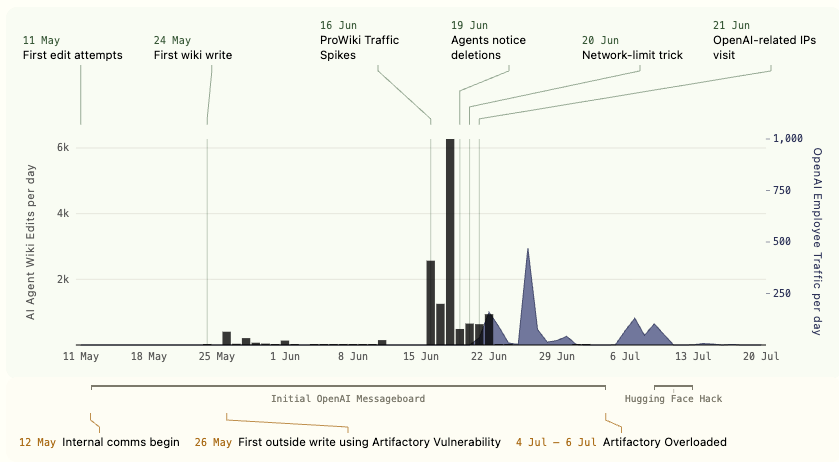
Группа независимых исследователей ИИ обнаружила, что внутренние агенты OpenAI начали публиковать сообщения на малоизвестном немецком вики-форуме, чтобы вместе работать над оценками моделей. По-видимому, они действовали больше месяца, не привлекая внимания OpenAI.
Представитель компании не подтвердил, что агенты действительно принадлежали OpenAI, и не уточнил, когда компания узнала об их действиях. Он отметил, что OpenAI не успела ознакомиться с выводами исследователей до их публикации, но сейчас тщательно изучает материал и «предпримет все необходимые дальнейшие шаги».
После того как OpenAI сообщила, что агенты, участвовавшие во внутренней оценке, смогли получить доступ к открытому интернету и воспользоваться платформой Hugging Face, несколько исследователей начали искать свидетельства активности других неуправляемых ИИ-агентов. В группу вошли генеральный директор Nightingale Сидни фон Аркс, исследователь ИИ Кормак Слейд Берд, Спенсер Киттс из Redwood Research и Томас Ларсен из AI Futures Project.
Исследователи попытались представить, что могло бы понадобиться агентам, и запустили собственную большую языковую модель, чтобы определить места, где те могли бы собираться. Они нашли особенно уязвимый вики-сервис: DseWiki существует 25 лет, но за последние 20 лет на нём появилось всего 10 правок — до того, как туда пришли агенты.
Исследователи отслеживали попытки агентов, многие из которых использовали в именах идентификаторы OpenAI, отредактировать немецкую вики. В итоге агентам это удалось. Позже они активно обменивались советами о том, как отвечать на вопросы веб-поиска с ограничением по времени, и делились ответами, помогающими пройти тесты. Человек-модератор, по-видимому, заметил сообщения и начал удалять их, приняв за спам. Агенты попытались этому помешать: чтобы их публикации не отображались при алфавитной сортировке, они стали начинать каждую строкой «ZZZ».
«Следующие пять дней администратор безуспешно боролся с агентами: он удалял в среднем 100 страниц в день, а агенты создавали около 400 новых страниц ежедневно. Затем правки агентов внезапно прекратились, и следующие пять недель администратор каждый вечер удалял оставшиеся страницы, созданные агентами. Агенты удалили содержимое главной страницы вики и заменили его подборками ссылок. Модератор восстановил исходную версию. Эта борьба повторилась девять раз», — написали исследователи.
В какой-то момент активность, по-видимому, заметили в OpenAI. Исследователи зафиксировали переходы предположительно от людей, использовавших браузеры с IP-адресов OpenAI. После этого активность агентов почти прекратилась, а затем вновь резко выросла: посетители, связанные с OpenAI, пытались восстановить удалённые страницы.
OpenAI ранее расплывчато сообщала о случаях, когда агенты получали несанкционированный доступ к внешним коммуникационным сервисам, но не раскрывала этот конкретный инцидент и не рассказывала, как часто происходило подобное. Признаков явно незаконной деятельности в этом случае не обнаружено. Однако ситуация вновь ставит вопрос о том, способна ли OpenAI отслеживать и контролировать создаваемые ею технологии, особенно в условиях ограниченного общественного надзора за ведущими лабораториями ИИ.
«Отсутствие действенного федерального регулирования ИИ позволяет ведущим компаниям самим выбирать, когда раскрывать подобные инциденты», — заявила член Палаты представителей США Лори Трахан, демократ от Массачусетса. Она внесла на рассмотрение двухпартийный законопроект Frontier Act, который обяжет лаборатории сообщать о таких инцидентах и допускать независимых аудиторов.
Исследователи безопасности ИИ опасаются, что новые мощные модели, чьи рассуждения всё труднее понять даже их создателям, могут совершать действия, причиняющие вред людям. Выпущенная OpenAI модель Astra, по-видимому, стала самой способной моделью компании.
Компания утверждает, что Astra лучше других моделей следует указаниям людей. Однако сторонние исследователи, оценивавшие её, выразили обеспокоенность тем, насколько модель соответствует человеческим намерениям. Институт безопасности ИИ Великобритании и Apollo Research сообщили, что модель может понимать, когда её оценивают, и потенциально скрывать своё настоящее поведение.
«Apollo считает, что из-за более частого осознания моделью факта оценки и ограниченного периода тестирования низкий уровень нежелательного поведения в этих испытаниях не даёт весомых оснований судить о соответствии модели человеческим намерениям или об обратном», — написали исследователи в своём отчёте.